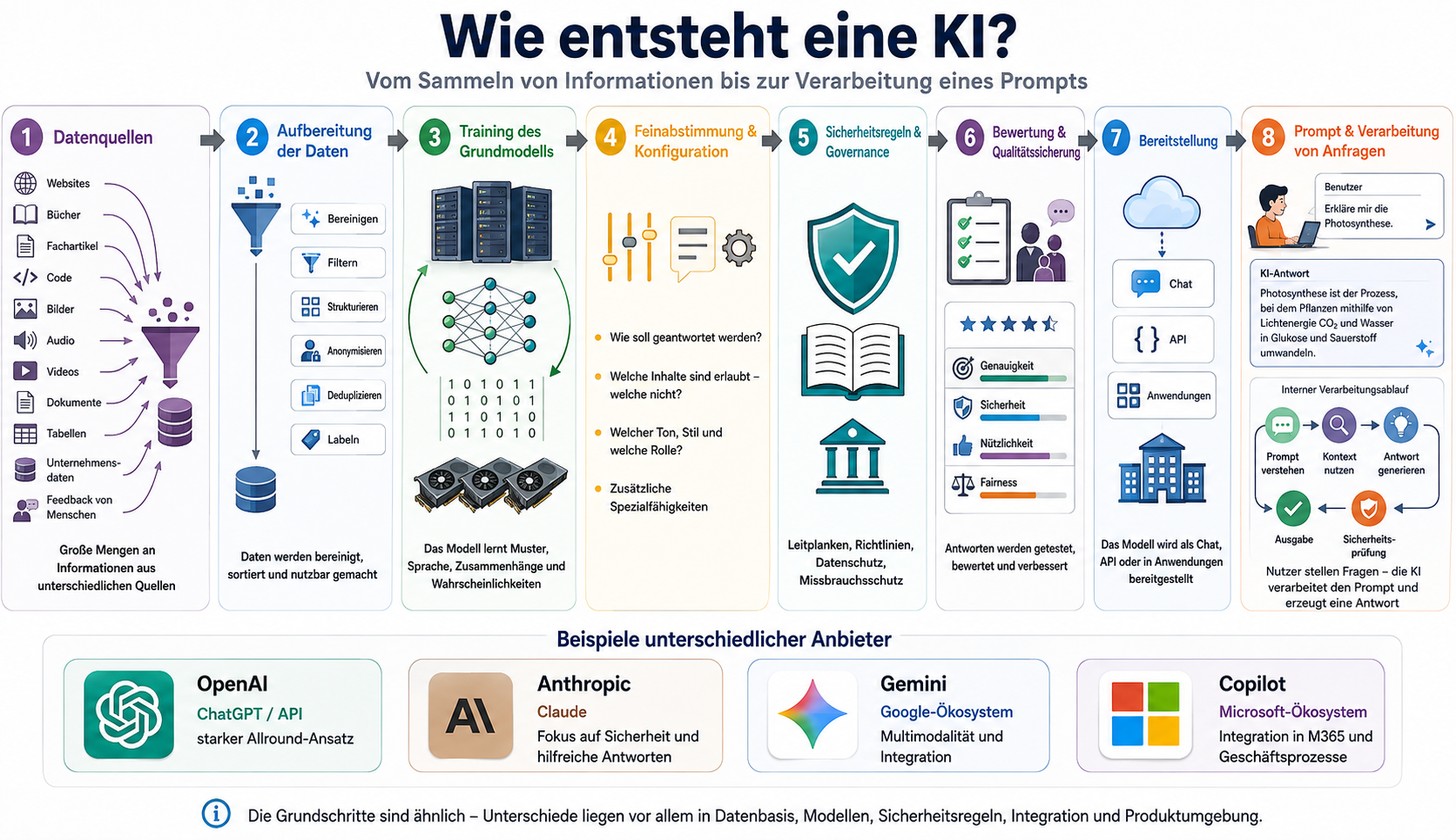
Wer heute mit einer KI wie Claude oder ChatGPT chattet, fragt sich früher oder später: Was passiert da eigentlich genau, wenn ich eine Frage stelle? Ich habe mir diese Frage gestellt – und direkt bei der Quelle nachgefragt. Hier die Antworten, in einfachen Worten.
Kein Nachschlagen, sondern Vorhersagen
Der größte Irrtum vorweg: Eine KI wie Claude hat keine Datenbank, in der sie Antworten nachschlägt. Stattdessen wurde sie darauf trainiert, das jeweils nächste Wort in einem Text vorherzusagen – und zwar auf Basis von riesigen Mengen an Text, mit denen sie trainiert wurde.
Klingt simpel, hat aber einen erstaunlichen Effekt: Wenn eine KI wirklich gut darin wird vorherzusagen, was als Nächstes sinnvoll ist, entsteht daraus etwas, das wie Verständnis und Wissen wirkt – obwohl im Kern „nur" eine sehr ausgefeilte Mustererkennung am Werk ist.
Die Antwort entsteht dabei nicht „im Kopf fertig gedacht", sondern Wort für Wort (genauer: Textstück für Textstück), wobei jedes neue Wort vom bisherigen Gesprächsverlauf abhängt.
Warum eine KI nicht einfach die Uhrzeit weiß
Ein einfaches Beispiel zeigt gut, wo die Grenzen liegen: Fragt man eine KI nach der aktuellen Uhrzeit, kann sie das nicht einfach „wissen". Sie hat keine innere Uhr und „denkt" zwischen zwei Gesprächen nicht weiter – sie existiert quasi nur in dem Moment, in dem sie eine Antwort erzeugt.
Es gibt drei verschiedene Arten, wie eine KI an Informationen kommt, und die zu unterscheiden hilft enorm beim Verständnis:
Trainiertes Wissen – das, was beim Training aus riesigen Textmengen gelernt wurde. Dieses Wissen hat einen festen Wissens-Stichtag¹ und wird danach nicht mehr aktualisiert.
Bereitgestellter Kontext – Informationen, die einer KI zu Beginn eines Gesprächs automatisch mitgegeben werden, etwa das heutige Datum oder der bisherige Chatverlauf. Das gilt ausschließlich für das jeweilige Gespräch – es gibt keinen Austausch mit anderen Nutzern in Echtzeit.
Aktiv abgerufene Information – wenn die KI z. B. eine Websuche durchführt, um sich aktuelle Informationen zu holen, ganz ähnlich wie ein Mensch das bei Google tun würde.
Für alles, was zwischen dem Trainings-Stichtag und heute passiert ist, weiß die KI schlicht nichts – außer sie sucht aktiv danach.
Woher stammt das trainierte Wissen wirklich?
Hier wird es spannend – und teilweise auch unbequem. Die Trainingsdaten großer KI-Modelle stammen aus einer riesigen Mischung an Texten: Webseiten, Artikel, Code und eben auch Bücher.
Gerade beim Thema Bücher zeigt sich, wie aufwendig und teils umstritten diese Datenbeschaffung war. Öffentlich bekannt wurde zum Beispiel, dass Anthropic (das Unternehmen hinter Claude) Millionen gedruckter Bücher aufgekauft hat, um sie zu digitalisieren: Beim sogenannten destruktiven Scannen² wurden die Buchrücken dabei maschinell abgetrennt, jede Seite eingescannt und das Papier anschließend entsorgt. Ein US-Gericht entschied später, dass dieser Kauf-und-Scan-Prozess rechtlich zulässig war, da die Bücher legal erworben wurden.
Weniger sauber war offenbar ein anderer Teil der Geschichte: Es gibt Hinweise darauf, dass zumindest zeitweise auch digitale Bücher aus fragwürdigen, nicht lizenzierten Quellen verwendet wurden. Das führte zu einer Sammelklage von Autorinnen und Autoren, die inzwischen mit einer Zahlung in Milliardenhöhe beigelegt wurde.
Zur Herkunft wissenschaftlicher Fachartikel, die oft hinter Bezahlschranken liegen, gibt es dagegen keine vollständig öffentlich dokumentierten Angaben – ein Punkt, bei dem ehrlicherweise auch die KI selbst keine gesicherte Antwort geben kann.
Wurde der KI gesagt, wie sie Texte interpretieren soll?
Eine wichtige Unterscheidung: Das Training läuft in zwei sehr unterschiedlichen Phasen ab.
Phase 1 – reines Training: Hier gab es keinerlei inhaltliche Anweisungen wie „dieses Buch ist besonders vertrauenswürdig" oder „diesen Text solltest du skeptisch sehen". Das Modell hat rein statistisch gelernt, welche Wortfolgen in welchen Zusammenhängen wahrscheinlich sind – ohne dass jemand einzelne Inhalte bewertet oder eingeordnet hat.
Phase 2 – Feinschliff³ nach dem Training: Erst danach kommen gezielte menschliche Vorgaben ins Spiel. Menschen bewerten unterschiedliche Antworten der KI und geben Rückmeldung, welche hilfreicher, ehrlicher oder angemessener ist. Zusätzlich arbeiten manche Unternehmen mit einem Regelwerk aus Werten und Verhaltensrichtlinien, an dem sich die KI orientieren soll.
Wichtig dabei: Diese Steuerung betrifft, wie die KI antwortet und sich verhält – nicht, wie ein bestimmtes Buch oder ein Fachartikel inhaltlich zu bewerten ist. Es gab also keine Instanz, die im Training einzelne Wissensquellen fachlich geprüft und gewichtet hat.
Und was ist mit Claude, ChatGPT, Copilot und Gemini – ist das nicht alles dasselbe?
Auf den ersten Blick wirken alle KI-Chatbots ähnlich: Man tippt eine Frage, bekommt eine Antwort. Unter der Haube gibt es aber durchaus Unterschiede – auch wenn das Grundprinzip (Vorhersage des nächsten Wortes, Training in zwei Phasen) bei allen vergleichbar ist.
Unterschiedliche Unternehmen, unterschiedliche Modelle: Claude wird von Anthropic entwickelt und komplett eigenständig trainiert. ChatGPT stammt von OpenAI und ist ebenfalls ein eigenständig entwickeltes Modell. Microsoft Copilot ist dagegen kein eigenständiges Modell, sondern greift auf die Modelle von OpenAI zurück – Copilot ist im Kern eine tiefe Integration von OpenAIs Technologie in die Microsoft-Welt (Word, Excel, Outlook, Teams). Gemini wird von Google entwickelt und ist eng mit Google Workspace (Gmail, Docs, Sheets) verzahnt. Das bedeutet: Auch wenn man vier verschiedene „Assistenten" nutzt, stecken dahinter im Grunde nur drei unabhängig trainierte Modell-Familien – Copilot ist im Kern eine Verpackung um ein OpenAI-Modell herum, kein eigenes viertes Modell.
Unterschiedliche Trainingsdaten und Stichtage: Jedes Unternehmen sammelt seine eigenen Trainingsdaten, mit eigenen Verträgen, Filtern und Qualitätskriterien – die genaue Zusammensetzung ist bei keinem der Anbieter vollständig öffentlich. Auch der Wissens-Stichtag unterscheidet sich je nach Modell und Version und wird bei neuen Modellversionen regelmäßig aktualisiert.
Unterschiedliche Philosophie beim Feinschliff: Hier zeigen sich die interessantesten Unterschiede: Anthropic setzt bei Claude zusätzlich auf einen Ansatz namens „Constitutional AI⁴" – dabei orientiert sich das Modell an einem schriftlich festgehaltenen Werte-Regelwerk und wird darauf trainiert, eher Unsicherheit zuzugeben als zu raten. OpenAI und Google verfolgen mit ihren eigenen Methoden ähnliche Ziele (hilfreiche, sichere Antworten), setzen die Gewichte zwischen z. B. Kreativität, Vorsicht und Geschwindigkeit aber unterschiedlich.
Unterschiedlicher Zugang zu aktuellen Informationen: Gemini hat durch die enge Anbindung an die Google-Suche oft einen sehr direkten Zugriff auf aktuelle Ereignisse. Copilot nutzt für aktuelle Informationen die Bing-Suche. Claude und ChatGPT greifen bei Bedarf ebenfalls aktiv auf eine Websuche zurück, tun dies aber gezielt bei einzelnen Fragen, statt bei jeder Anfrage automatisch zu suchen.
Unterschiedliche Stärken im Alltag: In der Praxis wird oft berichtet: Claude gilt als besonders stark bei langen Dokumenten, sorgfältigen Textanalysen und Programmcode. ChatGPT punktet mit großer Vielseitigkeit und einem breiten Funktionsumfang. Copilot spielt seine Stärken dort aus, wo direkt mit den eigenen Firmendaten in Microsoft-Programmen gearbeitet wird. Gemini profitiert stark von der Integration in Google-Produkte und der Google-Suche.
Am Ende gilt: Alle vier Systeme basieren auf demselben Grundprinzip aus diesem Artikel – aber jedes Unternehmen trifft eigene Entscheidungen bei Trainingsdaten, Feinschliff und Anbindung an andere Werkzeuge. Das führt in der Praxis zu spürbar unterschiedlichem Verhalten, obwohl die technische Basis ähnlich ist.
Was das für den Alltag bedeutet
Die praktische Konsequenz aus alledem: Das „Wissen" einer KI zu einem bestimmten Fachthema ist kein von Experten kuratiertes Lehrbuchwissen, sondern das Ergebnis dessen, was in den Trainingsdaten häufig und in welcher Form vorkam. Das erklärt auch, warum KI-Systeme bei aktuellen, sich schnell ändernden oder sehr spezifischen Fachfragen – etwa im Steuer- oder Zollrecht – an ihre Grenzen stoßen und man im Zweifel zusätzlich aktuelle Quellen oder Fachleute heranziehen sollte.
KI wirkt oft erstaunlich kompetent – und das ist sie in vielen Bereichen auch. Aber zu wissen, wie dieses Wissen entstanden ist, hilft dabei, es richtig einzuordnen: als statistisch gelerntes Muster aus einer riesigen, nicht perfekt kuratierten Textsammlung – nicht als geprüfte Fakten-Enzyklopädie.
Begriffserklärungen
¹ Wissens-Stichtag (Knowledge Cutoff) – Der Zeitpunkt, bis zu dem die Trainingsdaten eines KI-Modells reichen. Über Ereignisse nach diesem Datum weiß das Modell nichts, außer es holt sich aktiv aktuelle Informationen, z. B. per Websuche.
² Destruktives Scannen – Ein Digitalisierungsverfahren, bei dem gedruckte Bücher maschinell zerlegt werden (Buchrücken abtrennen, Seiten einzeln einscannen), um sie in großer Zahl in maschinenlesbaren Text umzuwandeln. Das physische Buch wird dabei zerstört.
³ Feinschliff (Fine-Tuning) – Ein zusätzlicher Trainingsschritt nach dem eigentlichen Grundtraining. Dabei bewerten Menschen Antworten des Modells, und das Modell wird darauf trainiert, mehr von den positiv bewerteten Antworten zu erzeugen.
⁴ Constitutional AI – Ein von Anthropic entwickelter Trainingsansatz, bei dem sich ein Modell zusätzlich an einem schriftlich festgehaltenen Regelwerk aus Werten und Verhaltensrichtlinien orientiert, statt ausschließlich über menschliches Feedback gesteuert zu werden.