Du tippst eine Frage ein. Ein paar Sekunden später steht eine Antwort da – flüssig, oft überraschend treffend. Aber was passiert in diesem kurzen Moment eigentlich wirklich?
Die kurze Antwort: kein Denken im menschlichen Sinn. Sondern Mustererkennung, Wahrscheinlichkeit und jede Menge Mathematik, die sich am Ende wie Verständnis anfühlt.
Lass uns das mal auseinandernehmen.
Der Weg von deiner Frage zur Antwort
1. Dein Text wird zerlegt
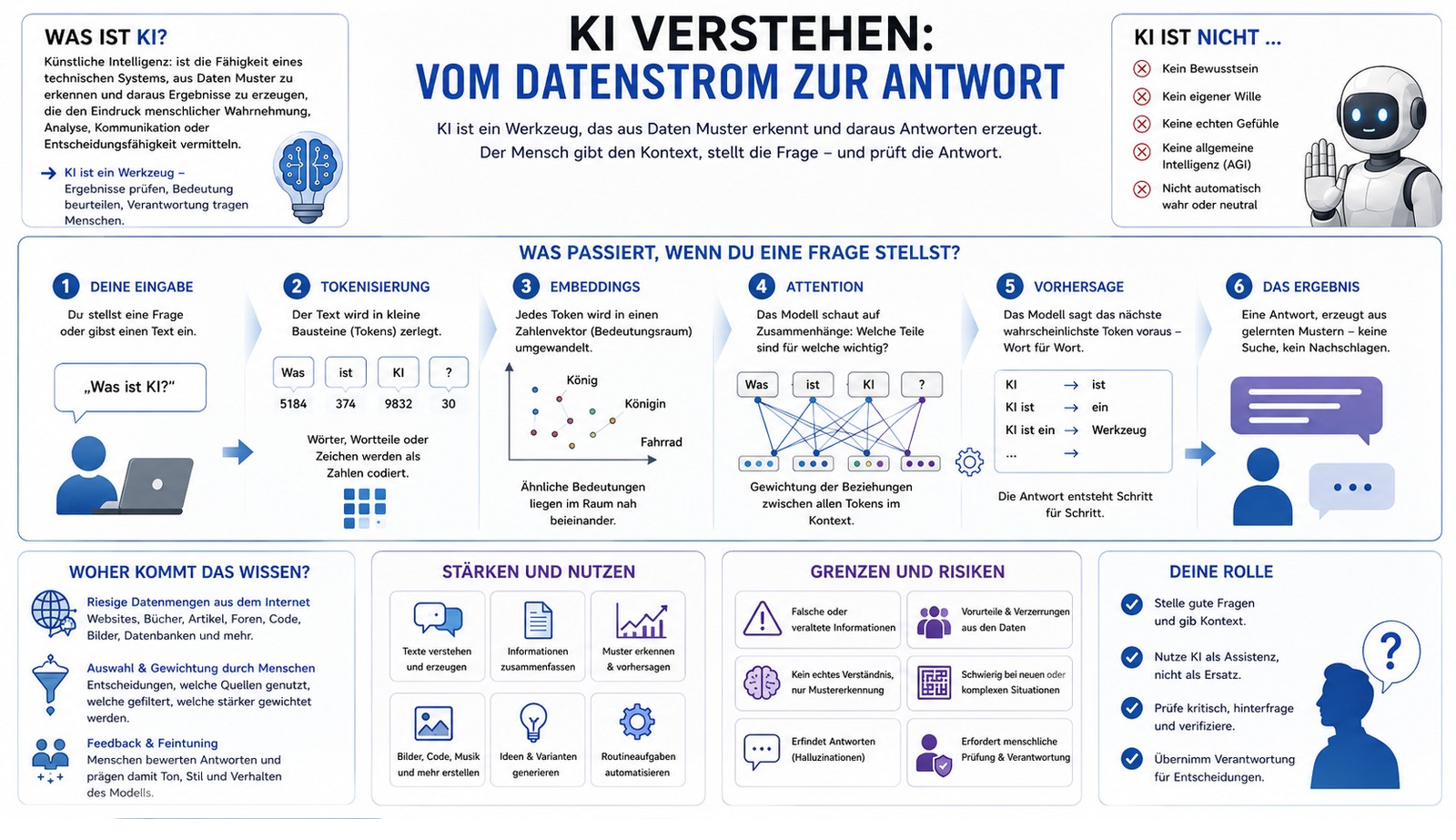
Als Erstes wird deine Eingabe nicht als „Satz" gelesen, sondern in kleine Bausteine zerhackt – sogenannte Tokens¹. Das können ganze Wörter sein, aber auch nur Wortteile. Jeder dieser Bausteine wird zu einer Zahl.
2. Zahlen werden zu Bedeutung
Jedes Token landet als Vektor² in einem riesigen „Bedeutungsraum" – einer langen Liste von Zahlen, die eine Position beschreibt. Ähnliche Begriffe liegen dort nah beieinander. „König" und „Königin" sind sich näher als „König" und „Fahrrad".
3. Attention³: Das Modell schaut auf Zusammenhänge
Hier passiert der eigentliche Trick moderner KI. Für jedes Wort berechnet das Modell, wie stark es mit jedem anderen Wort im Satz zusammenhängt.
Ein Beispiel dazu: „Die Bank am Fluss war nass." Ohne Kontext ist „Bank" mehrdeutig – Geldinstitut oder Ufer? Das Modell gewichtet die Wörter im Satz gegeneinander, und „Fluss" bekommt dabei besonders viel Gewicht. Diese starke Verbindung kippt die Bedeutung von „Bank" Richtung Flussufer. Das passiert nicht einmal, sondern in vielen Schichten übereinander – mit jeder Schicht wird die Bedeutung präziser.
4. Vorhersage statt Nachdenken
Am Ende berechnet das Modell: Welches nächste Wort ist am wahrscheinlichsten? Die Antwort entsteht Stück für Stück, jedes Mal basierend auf allem, was vorher da war.
5. Kein Nachschlagen, sondern Destillat
Wichtig zu verstehen: Eine KI durchsucht keine Datenbank nach der richtigen Antwort. Das Wissen steckt verteilt in Milliarden Zahlenwerten, die beim Training entstanden sind – eher ein extrem komprimiertes statistisches Destillat aus Texten als eine Bibliothek mit Karteikarten.
Der wichtigere Teil: Wie wurde die KI trainiert?
Das Verfahren oben erklärt das Wie einer einzelnen Antwort. Aber die eigentlich entscheidende Frage ist eine andere: Womit wurde das Modell gefüttert, bevor es überhaupt antworten konnte?
Denn genau hier entsteht die Prägung, die jede KI-Antwort mitträgt.
Ebene 1 – Die Trainingsdaten selbst
Das Grundtraining passiert mit riesigen Textmengen aus dem Internet: Wikipedia, Foren, Nachrichtenseiten, Bücher, Code. Alles, was im Netz an Verzerrungen steckt, steckt danach auch im Modell. Überrepräsentierte Sprachen, überrepräsentierte Perspektiven, veraltete Fakten, unbemerkte Vorurteile.
Ebene 2 – Auswahl und Gewichtung der Daten
Hier kommen Menschen ins Spiel. Unternehmen entscheiden, welche Quellen reinkommen und welche rausgefiltert werden, welche Sprachen oder Themenbereiche stärker gewichtet werden. Das ist bereits eine Wertentscheidung – auch wenn sie mit guten Absichten wie Qualität oder Sicherheit begründet wird.
Ebene 3 – Fine-Tuning⁴ durch menschliches Feedback
Nach dem Grundtraining bewerten Menschen Antworten als gut oder schlecht, und das Modell wird darauf trainiert, mehr vom „Guten" zu liefern. Hier fließen ganz direkt die Ansichten der Bewertenden ein: Was gilt als hilfreich? Was als angemessen? Welcher Ton ist erwünscht?
Die Konsequenz: Es gibt keine neutrale KI. Jedes Modell trägt eine Prägung in sich – durch die Datenauswahl, durch die Menschen, die es bewertet haben, durch die Kultur des Unternehmens dahinter. Genau deshalb antworten ChatGPT, Claude oder Gemini bei politisch oder kulturell aufgeladenen Fragen manchmal unterschiedlich.
Wo die Mustererkennung an Grenzen stößt
Ein paar Beispiele machen greifbar, wo das Ganze eben doch kein echtes Verständnis ist:
Buchstaben zählen: Die Frage „Wie viele Buchstaben hat 'Erdbeere'?" klingt trivial. Menschen zählen einfach. Eine KI verarbeitet Text aber in Tokens, die nicht zwingend einzelne Buchstaben sind – das Wort könnte als ein oder zwei Bausteine verarbeitet werden, nicht als acht Einzelbuchstaben. Das führt manchmal zu Fehlern bei scheinbar simplen Aufgaben.
Logik ohne echtes Weltwissen: „Ich habe die Schraube angezogen, weil sie zu locker war" versus „...weil sie zu groß war". Menschen erkennen sofort, dass der zweite Satz eigentlich unlogisch ist. Ein Sprachmodell löst das über gelernte Muster, wie diese Wörter typischerweise zusammen auftreten – nicht über echtes physikalisches Verständnis von Schrauben.
Antworten ohne Erleben: Fragt man „Warum ist der Himmel blau?", kommt eine korrekte, flüssige Antwort zur Rayleigh-Streuung⁵. Aber die KI hat nie einen blauen Himmel gesehen. Die Antwort ist eine Rekombination aus Millionen Texten über Physik – nicht abgeleitetes Wissen aus eigener Beobachtung.
Was bleibt
Es entsteht der Eindruck von Denken, weil Sprache selbst so eng mit Denken verwoben ist. Der Mechanismus dahinter bleibt aber Mustererkennung und Wahrscheinlichkeit – geprägt von den Daten und den Menschen, die das jeweilige Modell geformt haben.
Was heißt das für dich im Alltag? Eine KI-Antwort ist ein guter Ausgangspunkt. Aber keine objektive Wahrheit – genauso wenig, wie ein einzelner Zeitungsartikel die ganze Geschichte erzählt. Gesunde Skepsis bleibt der beste Kompass, gerade bei gesellschaftlich aufgeladenen Themen.
Begriffserklärungen
¹ Token – Ein Textbaustein, in den KI-Modelle Sprache zerlegen. Kann ein ganzes Wort sein, ein Wortteil oder ein einzelnes Zeichen. „Erdbeere" könnte z. B. als ein oder zwei Tokens verarbeitet werden, nicht als acht Einzelbuchstaben.
² Vektor – Eine lange Liste von Zahlen, die eine Position in einem mathematischen Raum beschreibt. In der KI dient sie dazu, die Bedeutung eines Wortes so darzustellen, dass ähnliche Begriffe rechnerisch „näher" beieinanderliegen als unähnliche.
³ Attention (Aufmerksamkeitsmechanismus) – Das zentrale Verfahren moderner Sprachmodelle. Es berechnet für jedes Wort, wie stark es mit jedem anderen Wort im selben Satz zusammenhängt, und nutzt das, um Mehrdeutigkeiten aus dem Kontext heraus aufzulösen.
⁴ Fine-Tuning – Ein zusätzlicher Trainingsschritt nach dem eigentlichen Grundtraining. Dabei bewerten Menschen Antworten des Modells, und das Modell wird darauf trainiert, mehr von den positiv bewerteten Antworten zu erzeugen.
⁵ Rayleigh-Streuung – Ein physikalisches Phänomen: Kurzwelliges (blaues) Licht wird beim Durchqueren der Erdatmosphäre stärker in alle Richtungen gestreut als langwelliges (rotes) Licht. Deshalb erscheint der Himmel tagsüber blau.