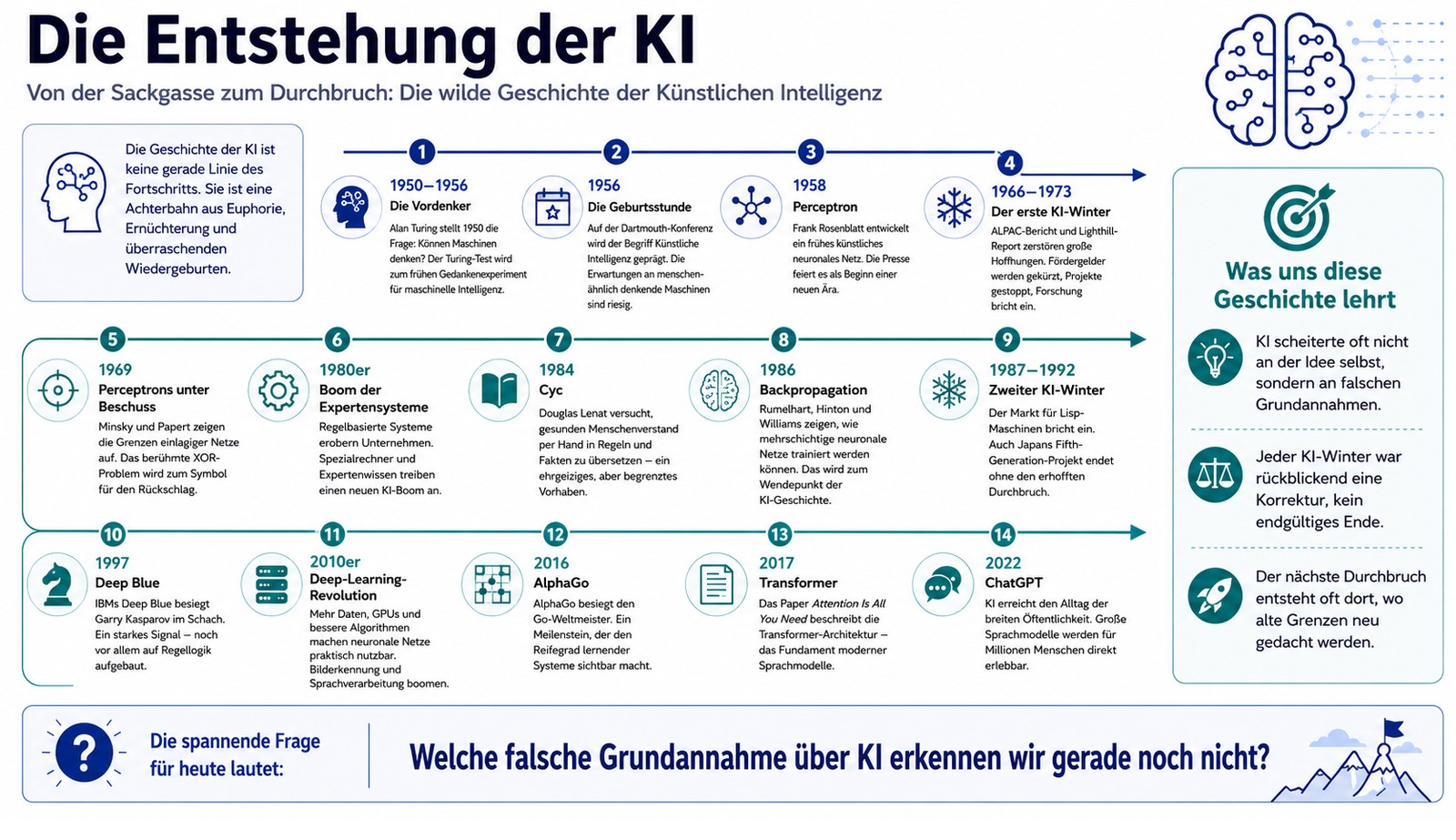
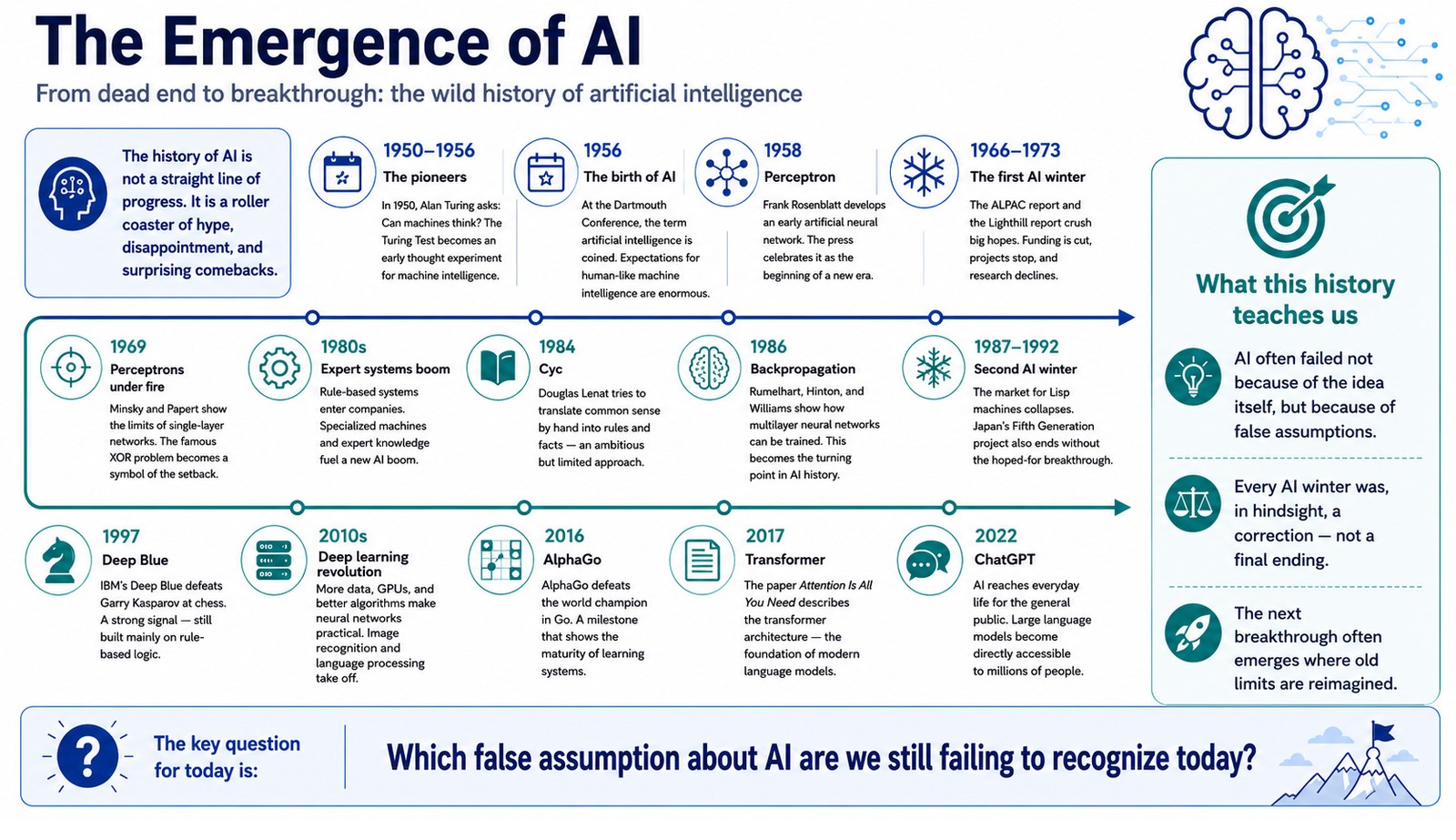
Stell dir vor, du liest 1958 eine Schlagzeile in der New York Times: Eine neue Maschine werde bald laufen, sprechen, sehen, schreiben und sich ihrer eigenen Existenz bewusst sein. Klingt nach 2024, oder? Es ist aber 66 Jahre älter. Die Geschichte der KI ist keine gerade Linie des Fortschritts – sie ist eine Achterbahn aus Euphorie, Ernüchterung und überraschenden Wiedergeburten. Und genau das macht sie so lesenswert.
Ein Hinweis vorab: Die folgenden Fakten, Daten und Beispiele stammen aus frei zugänglichen Quellen im Internet – wissenschaftlichen Papern, Archivmaterial, Fachartikeln und historischen Übersichten. Die zentralen Ereignisse und Jahreszahlen sind gut belegt, an einzelnen Stellen (etwa bei genauen Budgetsummen oder Detailformulierungen historischer Zitate) gibt es je nach Quelle aber leichte Abweichungen oder Unschärfen. Wo Zahlen unterschiedlich angegeben werden, wurde die gängigste bzw. eine vorsichtige Schätzung gewählt.
Der Werdegang im Überblick
Bevor wir tief eintauchen, lohnt sich der Blick auf die große Linie – die wichtigsten Etappen auf einen Blick:
- 1950–1956 – Die Vordenker: Alan Turing stellt 1950 die Frage „Können Maschinen denken?" und liefert mit dem Turing-Test¹ ein erstes Gedankenexperiment dazu.
- 1956 – Die Geburtsstunde: Auf der Dartmouth-Konferenz wird der Begriff „Künstliche Intelligenz" geprägt. Offizieller Startpunkt des Forschungsfelds, mit riesigen Erwartungen an eine baldige menschenähnliche Maschinenintelligenz.
- 1970er – Der erste KI-Winter: Hochgesteckte Versprechen werden nicht erfüllt, Rechenleistung reicht nicht aus, Fördergelder werden gekürzt.
- 1980er – Expertensysteme: Ein zweiter Boom durch regelbasierte Systeme in Unternehmen, etwa für medizinische Diagnosen. Endet erneut in einem Einbruch (zweiter KI-Winter, Ende der 80er).
- 1990er–2000er – Maschinelles Lernen wird zentral: Statt starrer Regeln setzt man zunehmend auf Systeme, die aus Daten lernen (Maschinelles Lernen²). 1997 schlägt Deep Blue den Schachweltmeister Kasparov.
- 2010er – Die Deep-Learning³-Revolution: Mehr Rechenleistung (GPUs⁴), riesige Datenmengen und bessere Algorithmen (neuronale Netze) bringen den Durchbruch: Bilderkennung, Sprachverarbeitung, 2016 schlägt AlphaGo den Go-Weltmeister.
- Seit ~2018/2020 – Die Ära der großen Sprachmodelle: Transformer-Architektur⁵ (2017), GPT-Modelle, ChatGPT (2022) – KI kommt im Alltag der breiten Öffentlichkeit an, statt nur in Fachkreisen zu existieren.
Das ist die Landkarte. Jetzt zur eigentlichen Geschichte dahinter – mit all ihren Sackgassen, Fehlschlägen und überraschenden Wendepunkten.
Ein Sommer, in dem alles begann
1956, Dartmouth College, USA. Eine Handvoll Wissenschaftler – darunter John McCarthy und Marvin Minsky – trifft sich für einen ganzen Sommer, um über „denkende Maschinen" zu diskutieren. Hier wird zum ersten Mal der Begriff geprägt, den wir heute überall lesen: Künstliche Intelligenz. Die Stimmung ist euphorisch. Man geht davon aus, dass Maschinen innerhalb einer Generation menschenähnlich denken können.
Sechs Jahre später baut Frank Rosenblatt das „Perceptron⁶" – ein einfaches künstliches Nervennetz⁷, das lernen kann, Muster zu erkennen. Die Presse ist außer sich. Die Marine finanziert das Projekt in der Hoffnung auf selbstlernende Kriegsmaschinen. Es fühlt sich an wie der Beginn einer neuen Ära.
Der erste Rückschlag: Ein Buch bringt alles zum Stillstand
1969 passiert etwas, das die gesamte Forschungsrichtung fast beendet. Marvin Minsky selbst – einer der KI-Gründerväter – veröffentlicht zusammen mit Seymour Papert ein Buch mit dem schlichten Titel „Perceptrons". Mathematisch sauber weisen sie nach: Diese einfachen Netze können nicht einmal simple logische Aufgaben lösen. Ein bestimmtes Problem – heute als XOR-Problem⁸ bekannt – ist für sie unlösbar.
Die Wirkung ist verheerend. Die Fördergelder für neuronale Netze versiegen praktisch über Nacht. Fast 15 Jahre lang traut sich kaum noch jemand, in diesem Bereich zu forschen. Ein einziges Buch hatte ein ganzes Forschungsfeld eingefroren.
Fast zeitgleich, aber unabhängig davon, bricht ein anderer großer Traum zusammen: die maschinelle Übersetzung. Nach dem Sputnik-Schock hatten die USA Millionen investiert, um russische Texte automatisch ins Englische zu übersetzen – man wollte wissen, was die Sowjets tun. 1966 kommt der ernüchternde ALPAC-Bericht: Die Maschinenübersetzungen sind langsamer, teurer und schlechter als die eines Menschen. Auch hier: Geld weg, Projekt tot.
Großbritannien setzt 1973 noch einen drauf. Ein Regierungsbericht von Sir James Lighthill erklärt die gesamte KI-Forschung für weitgehend gescheitert. Die Folge: Fast alle britischen Universitäten stellen ihre KI-Forschung ein. Der erste „KI-Winter⁹" ist da – eine Zeit, in der das Wort „Künstliche Intelligenz" in Förderanträgen fast schon toxisch wird.
Die 80er: Ein neuer Frühling – und ein noch härterer Winter
Doch Wissenschaft stirbt selten endgültig. In den 1980ern entsteht eine neue Idee: Statt Maschinen selbst lernen zu lassen, füttert man sie mit Expertenwissen in Form starrer Regeln. Diese „Expertensysteme¹⁰" boomen. Firmen bauen spezielle Computer – sogenannte Lisp-Maschinen – nur um diese Systeme zu betreiben. Ein Milliardenmarkt entsteht praktisch aus dem Nichts.
Und dann, 1987, bricht dieser Markt fast über Nacht zusammen. Die Regeln waren zu starr, zu teuer zu warten – jede neue Regel konnte zehn alte durcheinanderbringen. Gleichzeitig werden normale PCs immer leistungsfähiger und billiger. Wozu eine teure Spezialmaschine kaufen? Der zweite KI-Winter beginnt.
In Japan läuft zur selben Zeit ein gigantisches Projekt namens „Fifth Generation Computer" – über 400 Millionen Dollar Staatsgelder fließen in den Plan, eine völlig neue Computergeneration mit eingebauter Logik zu bauen. Zehn Jahre später, 1992, wird das Projekt leise beendet. Die hochgesteckten Ziele wurden nie erreicht.
Ein weiteres Projekt aus dieser Zeit verdient besondere Erwähnung, weil es bis heute weiterläuft, aber sein ursprüngliches Versprechen nie einlöste: Cyc. Seit 1984 versucht Douglas Lenat, gesunden Menschenverstand in eine Maschine zu programmieren – von Hand, Fakt für Fakt, Regel für Regel. Millionen von Einträgen später zeigt sich: Der Ansatz stößt an eine unsichtbare Wand. Man kann der Welt ihre Komplexität nicht von Hand eintippen.
Die Wende: Ein alter Algorithmus wird wiederentdeckt
Und dann, 1986, geschieht der eigentliche Wendepunkt der gesamten Geschichte – fast unbemerkt von der Öffentlichkeit. Die Forscher David Rumelhart, Geoffrey Hinton und Ronald Williams zeigen: Das Problem von 1969 galt nur für einlagige neuronale Netze. Baut man mehrere Schichten übereinander und nutzt einen Trick namens Backpropagation¹¹, um den Fehler durch das Netz zurückzuschicken, lösen sich plötzlich Probleme, die zuvor unmöglich schienen.
Das Perceptron-Todesurteil von Minsky und Papert war also kein grundsätzliches Urteil über neuronale Netze – es galt nur für eine zu einfache Version davon. Diese Erkenntnis liefert die Blaupause für alles, was danach kommt.
Trotzdem dauert es noch Jahrzehnte, bis diese Idee ihre volle Kraft entfalten kann. Es fehlen zwei Dinge: genug Daten und genug Rechenleistung. 1997 schlägt IBMs Deep Blue den Schachweltmeister Garry Kasparov – ein wichtiges Signal, aber noch auf reiner Regellogik gebaut, nicht auf Lernen.
Die Explosion: Als plötzlich alles zusammenkam
Ab den 2010er Jahren ändert sich alles. Grafikkarten (ursprünglich für Videospiele gebaut) erweisen sich als ideal, um die massiven Berechnungen neuronaler Netze durchzuführen. Das Internet liefert gigantische Mengen an Trainingsdaten. Und die alte Backpropagation-Idee von 1986 entfaltet plötzlich ihre volle Wirkung.
2016 schlägt AlphaGo den Weltmeister im Brettspiel Go – ein Spiel, das als so komplex galt, dass Experten diesen Moment erst für Jahrzehnte später erwartet hatten. 2017 erscheint ein wissenschaftliches Paper mit dem unscheinbaren Titel „Attention Is All You Need" – es beschreibt die sogenannte Transformer-Architektur, das technische Fundament, auf dem praktisch jedes moderne Sprachmodell aufbaut.
Und dann, 2022, verlässt KI zum ersten Mal in großem Stil die Fachwelt und kommt im Alltag von Millionen Menschen an: ChatGPT wird veröffentlicht. Was 1956 in einem Sommer in Dartmouth als kühne Vision begann, was zweimal fast gestorben wäre, was Jahrzehnte in Vergessenheit geriet – ist plötzlich Teil des ganz normalen Alltags.
Was uns diese Geschichte lehrt
Das Faszinierende an all diesen gescheiterten Projekten: Fast immer lag der eigentliche Fehler nicht in der Idee „Künstliche Intelligenz" selbst, sondern in einer zu engen Annahme darüber, wie man sie bauen müsste. Einlagige statt mehrschichtiger Netze. Regeln von Hand statt Lernen aus Daten. Symbolische Logik statt Skalierung.
Jeder „KI-Winter" war rückblickend weniger ein Ende als eine schmerzhafte Korrektur einer falschen Grundannahme – oft ein Wechsel von symbolischer KI¹² hin zu datengetriebenem Lernen. Und jeder Wiedereinstieg begann mit einem konkreten, überprüfbaren Beweis, dass diese Korrektur tatsächlich funktioniert – Backpropagation, statistische Übersetzung, GPU-beschleunigtes Deep Learning.
Eine gute Erinnerung für uns heute: Auch der aktuelle KI-Boom wird irgendwann an seine eigenen Grenzen stoßen. Die spannende Frage ist nicht, ob das passiert – sondern welche falsche Grundannahme wir gerade noch nicht erkannt haben.
Glossar: Fachbegriffe einfach erklärt
¹ Turing-Test – Ein von Alan Turing 1950 vorgeschlagener Test: Kann ein Mensch im Gespräch nicht mehr unterscheiden, ob er mit einer Maschine oder einem Menschen kommuniziert, gilt die Maschine als „denkend".
² Maschinelles Lernen (ML) – Der Oberbegriff für Verfahren, bei denen ein Computer nicht mit festen Regeln programmiert wird, sondern selbstständig Muster aus Beispieldaten erkennt und daraus Vorhersagen ableitet.
³ Deep Learning – Ein Teilbereich des maschinellen Lernens, der auf besonders vielen übereinandergeschichteten Ebenen („tiefe" neuronale Netze) basiert. Ermöglicht das Erkennen sehr komplexer Muster, etwa in Bildern oder Sprache.
⁴ GPU (Graphics Processing Unit / Grafikprozessor) – Ursprünglich für die Berechnung von Videospiel-Grafiken entwickelt. Stellt sich als ideal für die massenhaften, parallelen Berechnungen heraus, die neuronale Netze benötigen – und macht moderne KI erst praktisch nutzbar.
⁵ Transformer-Architektur – Ein 2017 vorgestelltes technisches Konzept, das es Modellen erlaubt, den Zusammenhang zwischen weit auseinanderliegenden Wörtern in einem Text besonders gut zu erfassen. Bildet die technische Grundlage aller modernen Sprachmodelle wie ChatGPT oder Claude.
⁶ Perceptron – Eines der allerersten künstlichen neuronalen Netze, entwickelt in den 1950er/60er Jahren. Ein sehr einfaches Modell, das grob nachahmt, wie eine einzelne Nervenzelle im Gehirn Signale verarbeitet.
⁷ Neuronales Netz – Ein Computermodell, das lose an die Funktionsweise des menschlichen Gehirns angelehnt ist. Besteht aus vielen einfachen, miteinander verbundenen Recheneinheiten („Neuronen"), die gemeinsam Muster erkennen lernen.
⁸ XOR-Problem – Eine einfache logische Aufgabe („entweder-oder, aber nicht beides"), die ein einlagiges Perceptron mathematisch nicht lösen kann. Wurde zum Symbol für die Grenzen früher neuronaler Netze.
⁹ KI-Winter – Bezeichnung für Phasen, in denen Förderung, öffentliches Interesse und Erwartungen an die KI-Forschung stark einbrechen, meist weil zuvor geweckte Erwartungen nicht erfüllt wurden.
¹⁰ Expertensystem – Ein KI-Ansatz aus den 1980ern: Statt aus Daten zu lernen, wird das Wissen von menschlichen Experten in Form fester „Wenn-Dann"-Regeln von Hand in das System eingegeben.
¹¹ Backpropagation – Ein mathematisches Verfahren, mit dem ein neuronales Netz aus seinen Fehlern lernt: Der Fehler am Ende der Berechnung wird rückwärts durch das Netz geschickt, um jede einzelne Verbindung ein kleines Stück zu verbessern.
¹² Symbolische KI – Ein älterer KI-Ansatz, bei dem Wissen als explizite Symbole und Logikregeln dargestellt wird (z. B. „Ein Vogel kann fliegen, außer er ist ein Pinguin"). Steht im Gegensatz zum heutigen datengetriebenen Lernen.